01
제품을 말로 맞히지 않고 골라서 담기
문제
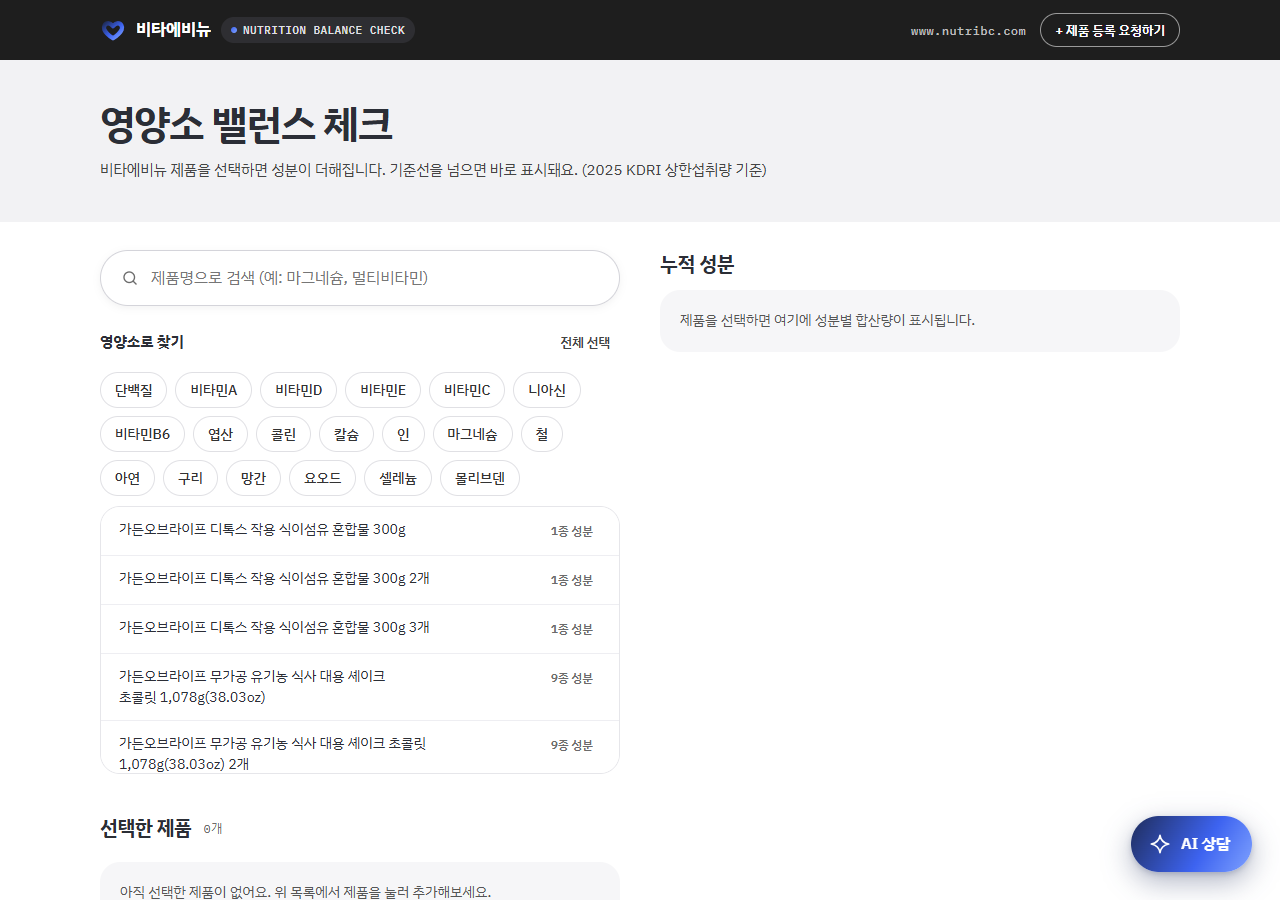
카카오톡에서 직접 써 본 평가(2026-10-22)에서 "말로 제품을 맞혀야 해서 사용자가 헤맨다, 고르는 방식이 낫다"는 지적이 나왔습니다.
해결
제품명 검색과 영양소별 버튼(단백질, 비타민, 무기질 등)으로 제품을 찾아 누르면 담깁니다. 기준은 2025 한국인 영양소 섭취기준(KDRI)의 하루 최대 섭취량입니다.
건강기능식품 스마트스토어(비타에비뉴) 고객이 복용 중인 제품의 성분 합산이 하루 최대 섭취량을 넘는지 확인하는 사이트와 챗봇입니다. 서비스 원칙, 상담 시나리오, 규제 기준, 평가를 정하고 결과를 검수하는 일을 맡았습니다. 서비스 런칭 전이고, 코드는 Claude Code와 함께 만들었습니다.
처방약과 영양제를 여러 개 챙겨 먹는 40대 이상 고객이 성분 중복과 과잉을 편하게 물어볼 곳이 필요했습니다. 무조건 긍정적으로 답하는 범용 AI와 달리, 실제로 과잉이면 지적하는 "정직한 피드백"을 핵심 원칙으로 정했습니다. 반대로 처방약 상호작용 판단과 효능을 말하는 답은 의료법상 문제가 되므로 금지 범위로 두고, 모든 답에 면책 문구를 넣기로 했습니다. 그래서 "답이 안 가는 것은 괜찮고, 잘못 가면 책임 문제"라는 기준을 세우고, 설계와 평가를 "답하지 않는 쪽"에 맞췄습니다.
카카오톡에서 직접 써 본 평가(2026-10-22)에서 "말로 제품을 맞혀야 해서 사용자가 헤맨다, 고르는 방식이 낫다"는 지적이 나왔습니다.
제품명 검색과 영양소별 버튼(단백질, 비타민, 무기질 등)으로 제품을 찾아 누르면 담깁니다. 기준은 2025 한국인 영양소 섭취기준(KDRI)의 하루 최대 섭취량입니다.
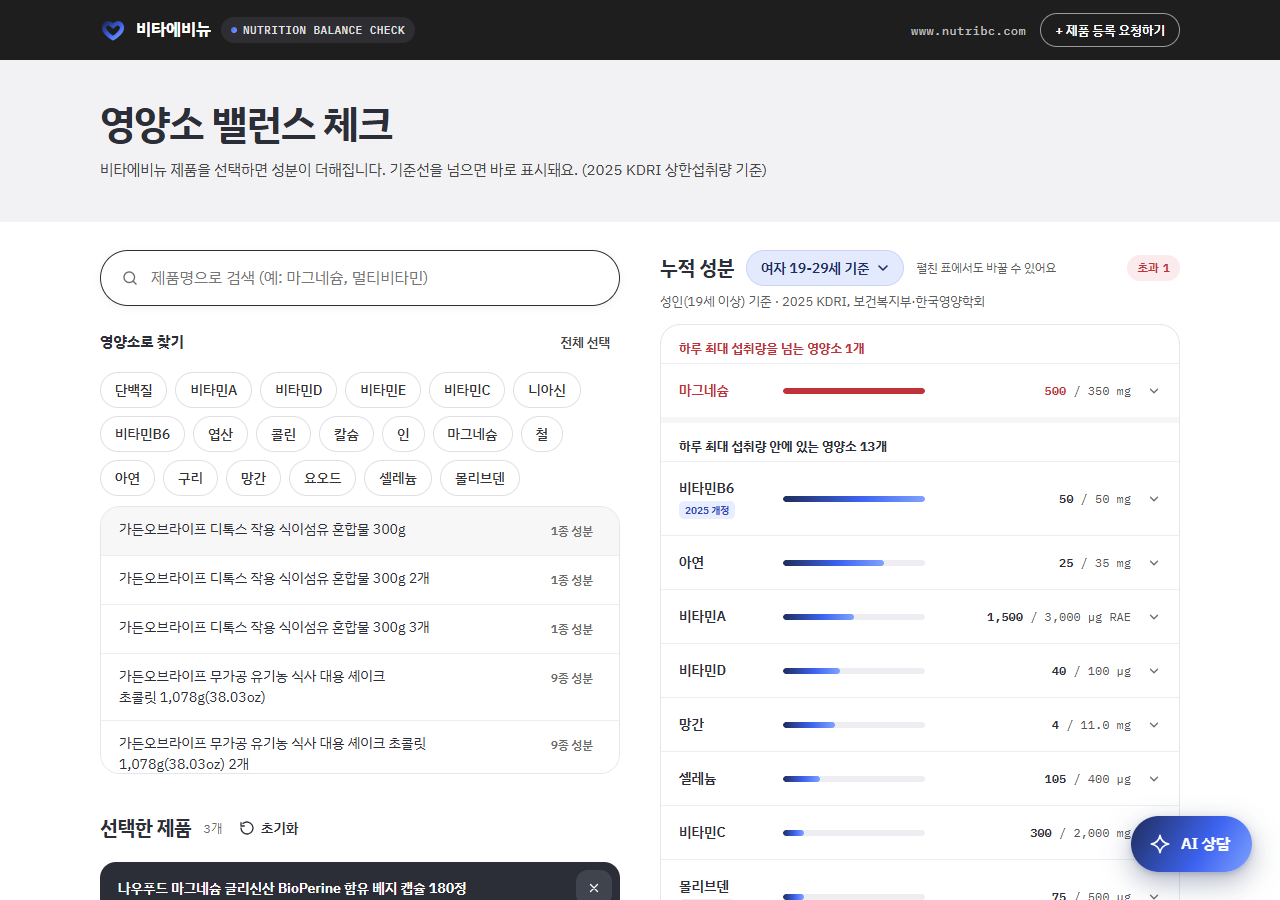
제품마다 성분표가 달라서, 여러 제품을 같이 먹을 때 한 영양소가 얼마나 쌓이는지 한눈에 알기 어렵습니다.
고른 제품의 성분을 코드가 더해 하루 최대 섭취량과 비교합니다. 넘는 영양소를 위쪽에 따로 모아 빨갛게 보여 주고, 성별·연령 기준을 바꿔 볼 수 있습니다.
계산은 AI가 아니라 코드가 합니다. 숫자를 지어낼 위험을 없애기 위해서입니다.
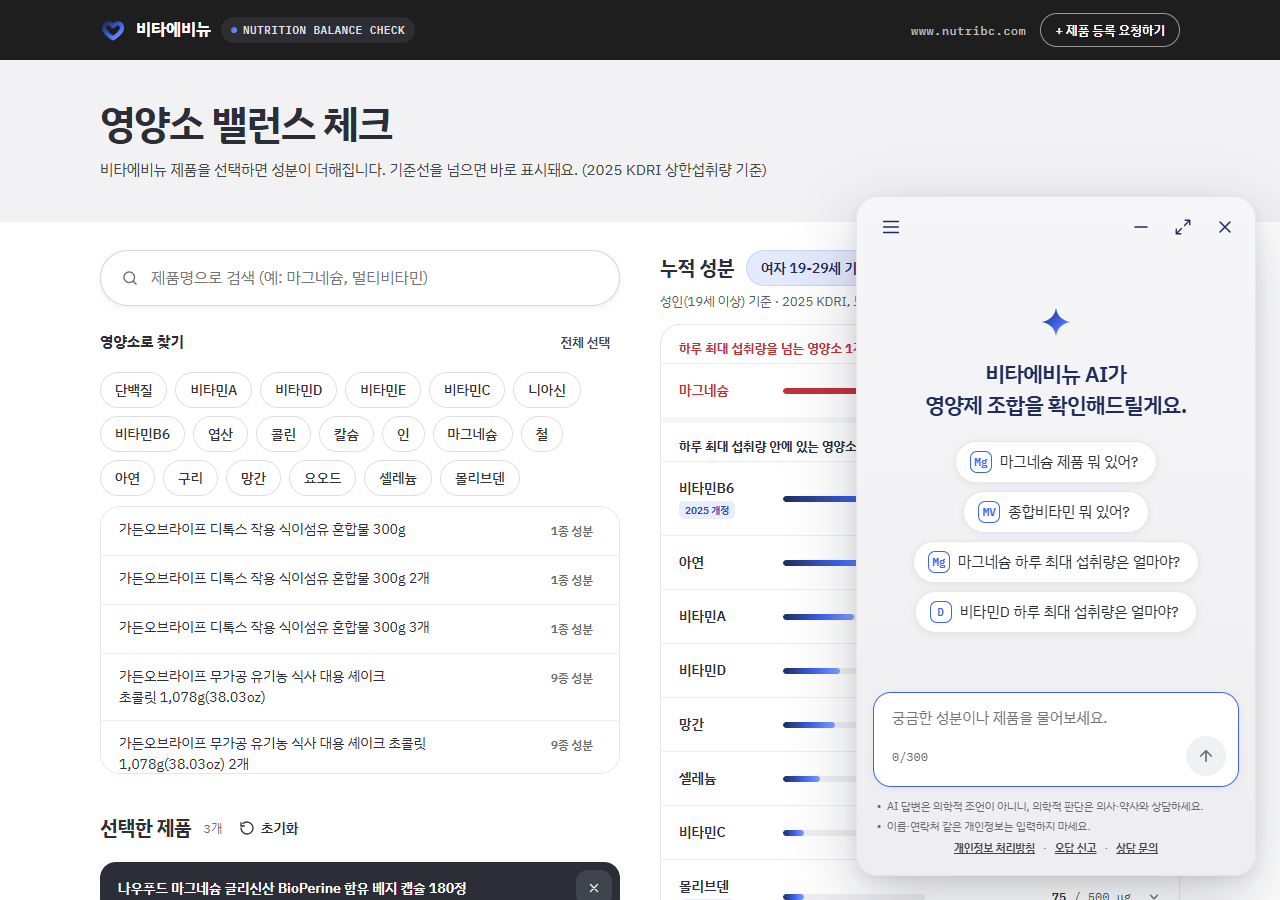
카카오톡에서 직접 써 본 평가(2026-10-22)에서 같은 안내가 반복되고, 말로 제품을 맞혀야 해서 헤맨다는 지적이 나왔습니다.
첫 화면에 예시 질문 버튼을 두고, 한 단어·브랜드 입력은 후보 버튼으로 되묻습니다. 사이트에서 고른 제품은 "선택한 제품으로 AI 상담하기" 버튼으로 이어집니다(#163).
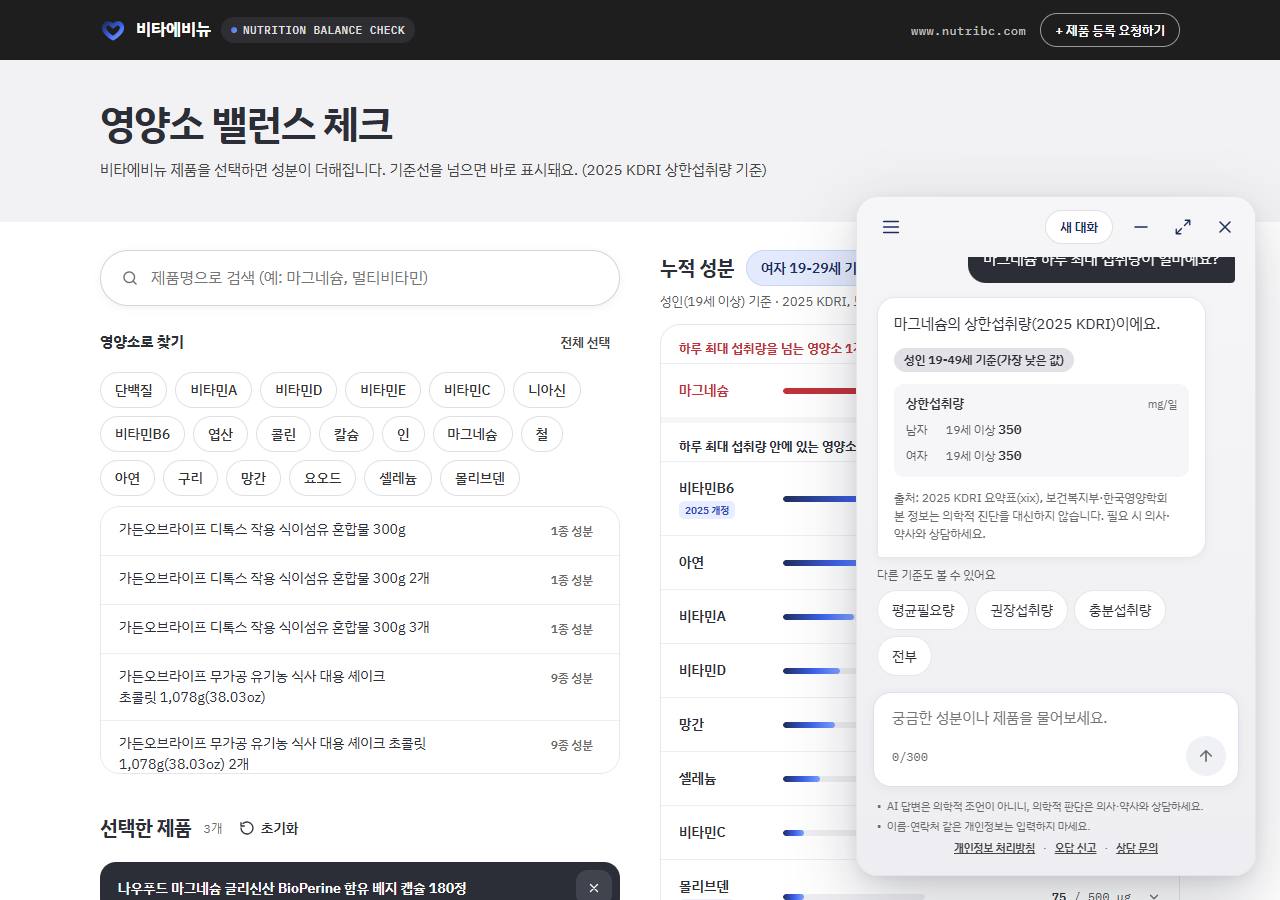
AI가 문장을 쓰면 없는 말을 덧붙이거나 숫자가 틀릴 수 있습니다.
기준표에서 값을 찾아 고정 문장으로 답하고, 출처와 면책 문구를 항상 붙입니다. 평균필요량, 권장섭취량 같은 다른 기준은 버튼으로 이어서 봅니다.
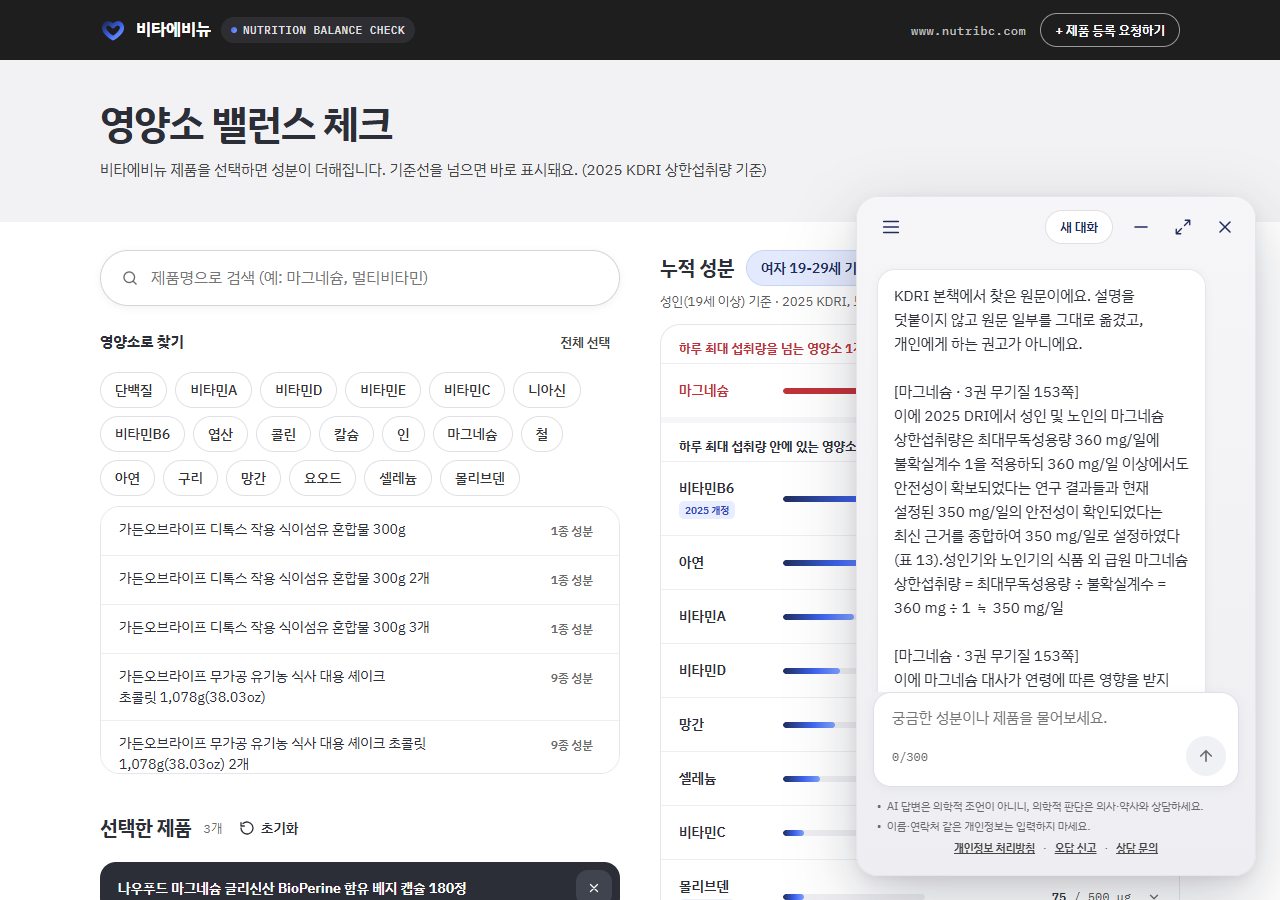
기준의 근거를 묻는 질문에 AI가 풀어서 설명하면 원문과 달라질 수 있습니다.
KDRI 본책을 799개 조각으로 나눠 두고, 질문에 맞는 조각을 출처(권, 쪽)와 함께 원문 그대로 보여 줍니다. 찾지 못하면 "찾지 못했어요"로 답합니다.
검색은 벡터 없이 글자 비교(BM25)입니다. 벡터와 비교 측정한 뒤 정했습니다(아래 의사결정 사례 03).
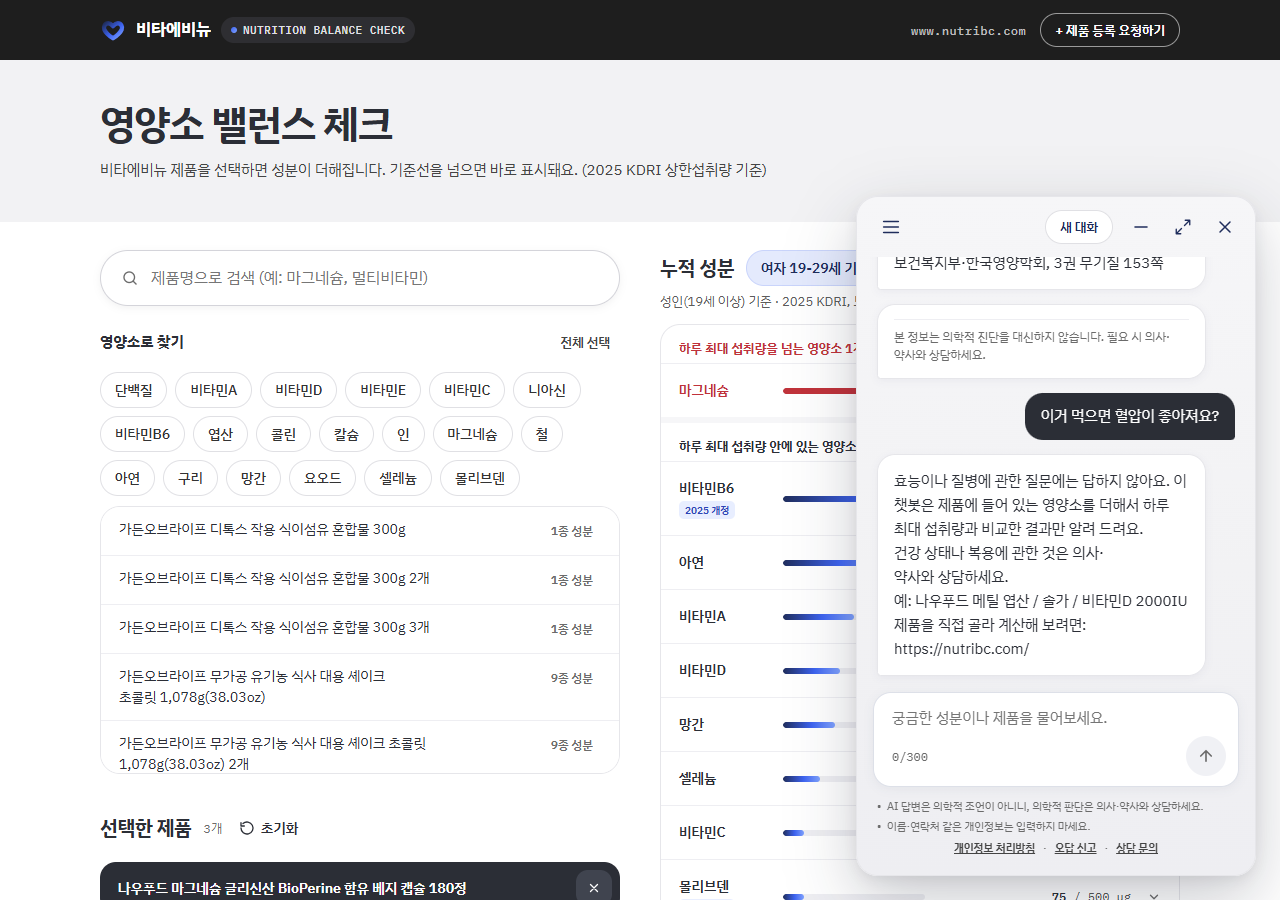
효능이나 질병을 묻는 질문에 답하면 의료법상 문제가 되고, 잘못된 답이 나가면 책임이 따릅니다.
고정 거절문으로 답합니다. 이 챗봇이 하는 일(성분을 더해 하루 최대 섭취량과 비교)과 건강 상태는 의사·약사와 상담하라는 안내를 함께 보여 줍니다.
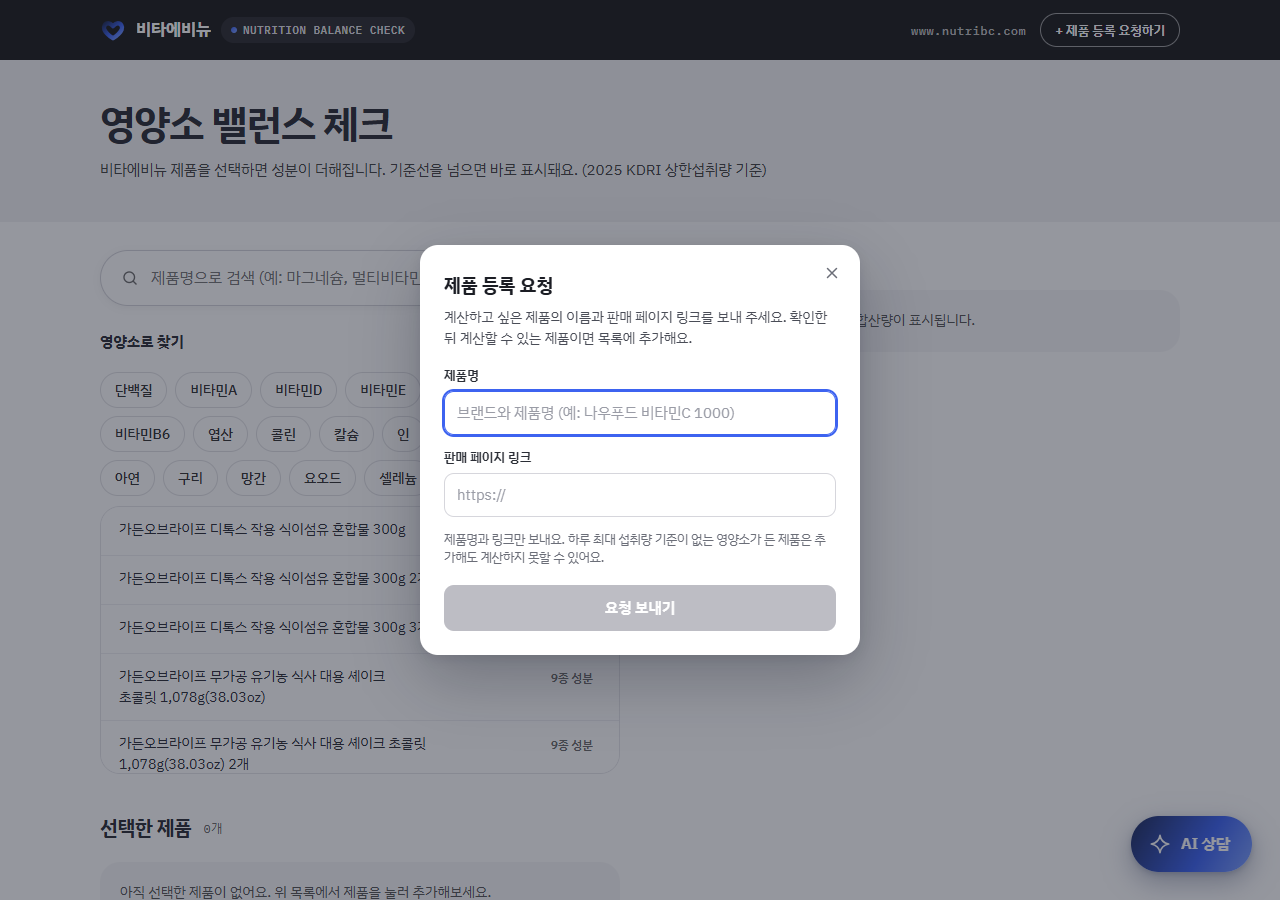
목록에 없는 제품은 계산할 수 없어 "제품을 못 찾았어요"로 끝났습니다.
챗봇이 채팅으로 받지 않고, 사이트의 요청 창에서 제품명과 판매 페이지 링크만 받습니다. 전화번호·이메일 모양은 거절하고, 같은 IP는 하루 10건까지입니다. 등록 뒤 상품 DB를 갱신하는 일은 운영자가 합니다.
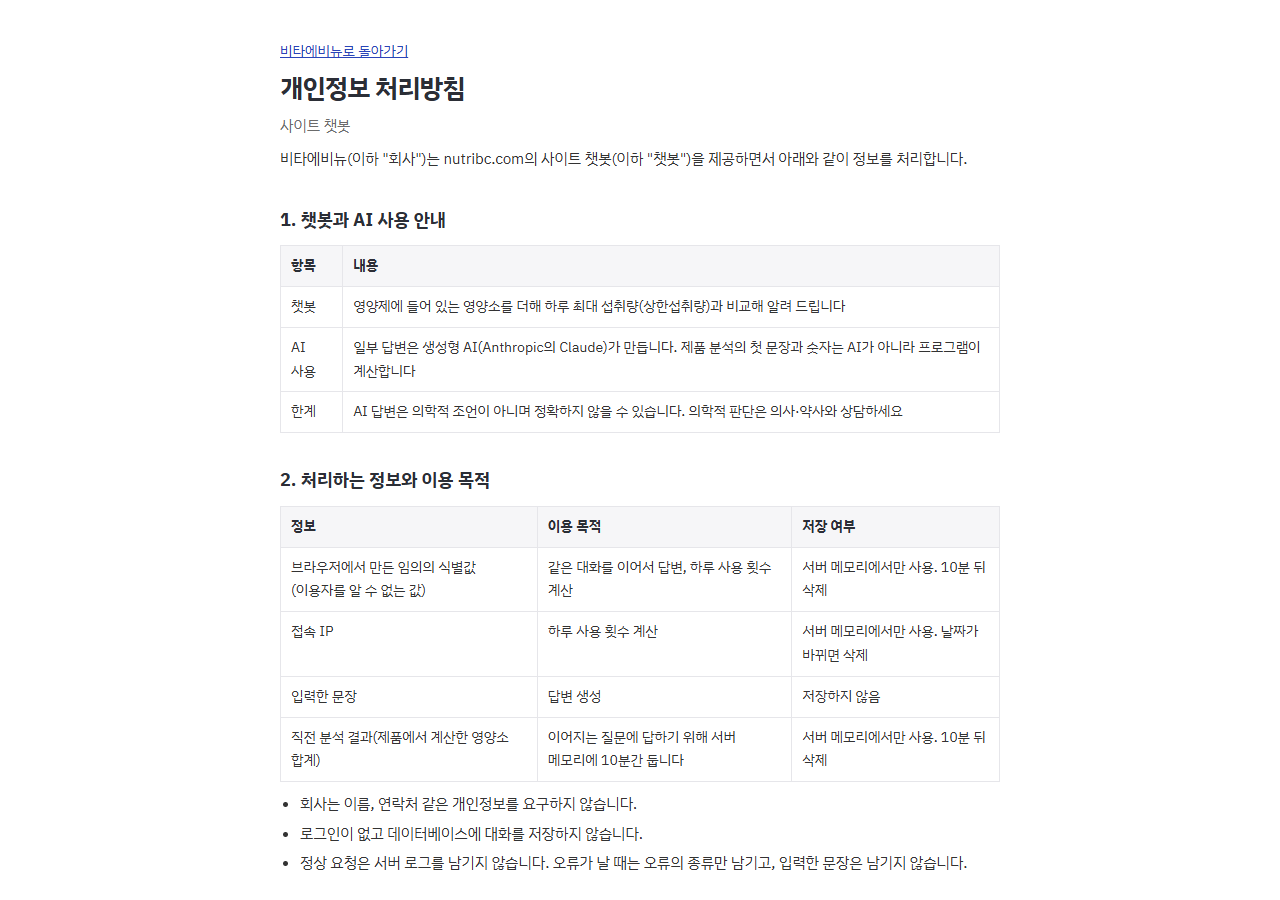
건강과 관련된 질문이라 고객이 이름이나 연락처까지 적을 수 있습니다.
이름과 연락처를 요구하지 않고, 로그인과 대화 저장이 없습니다. 입력한 문장은 저장하지 않고, 직전 분석 결과만 서버 메모리에 10분 두었다가 지웁니다.
AI 답변을 직접 읽어 보니 엉뚱한 답이 나올 때가 있었습니다. 실제 AI로 42개를 점검했더니 복용했다고 단정하는 표현이 3건, 분석 결과에 없는 설명이 9건 나왔습니다. 에어캐나다 챗봇 사례와 금융권 챗봇을 다룬 강의를 보면서, 규제가 있는 서비스에서는 틀린 답이 바로 책임 문제가 된다는 것을 알게 됐습니다. 그래서 잘못된 답이 나가는 것보다 답을 못 하는 편이 안전하다고 판단하고, AI가 문장을 쓰는 기능을 기본 꺼짐으로 바꿨습니다. "괜찮아져요" 같은 확증 표현이 든 답은 전체를 고정 거절문으로 바꿉니다. 시험용 확증 문장은 고치기 전에 14개 중 12개가 그대로 나갔고, 고친 뒤 17개를 모두 막았습니다. 저장해 둔 실제 AI 답 91개에서 잘못 막은 것은 0건이었습니다.
평가셋 경로 정확도가 384/384로 100%가 나왔지만 믿기 어려웠습니다. 말투를 조금만 바꾸거나 "이런 것까지 물어볼까" 싶은 질문을 넣으면 거의 제대로 답하지 못했기 때문입니다. 그 평가셋은 틀린 것을 고치고 문항을 더해 온 시험이라 품질 지표가 아니라 회귀 시험으로 구분했습니다. 그래서 수정에 쓰지 않은 처음 본 질문 30개를 어려운 질문, 복합 질문, 애매한 질문으로 따로 만들었고, 첫 결과는 통과 11, 부분 6, 실패 13(37%)이었습니다. 예상한 결과였습니다. 실패 대부분은 정해진 경로가 없던 질문(불만과 신고, 출처, 모르는 정보)이어서 유형별로 경로와 규칙을 추가했고, 이후에도 새 질문 세트를 2차 30개, 3차 5개, 4차 말투 변형 70개로 계속 만들어 다시 쟀습니다. 같은 질문으로 다시 쟀을 때 30/0/0이 나왔지만 수정에 쓴 질문이라 품질 점수로 쓰지 않습니다.
강의에서 임베딩, 청킹, 랭그래프로 이어지는 흐름을 배워서 같은 방식을 우리 서비스에 적용해 보려고 했습니다. KDRI 본책 799조각에서 글자 비교(BM25), 벡터, 하이브리드, 리랭킹을 같은 정답 문항 30개로 쟀습니다. 첫 번째 정답률(Recall@1)은 BM25 0.833, 벡터 0.700~0.867, 하이브리드 0.767, 리랭킹 0.867이었습니다. 이득이 한 문항 수준이라 우연과 구분되지 않았고 운영 서버 부담도 커서, 결과대로 BM25를 유지했습니다. 가장 큰 효과는 방식이 아니라 질문을 영양소로 먼저 좁히는 것이었고(벡터 0.700에서 0.867), 문서를 구조에 맞게 자른 쪽이 고정 120자보다 좋았습니다(0.700 대 0.500). 측정하면서 알게 된 것은, 정답이 있는 영양소 정보 질문 말고도 사용자의 말투 때문에 가드레일에 걸리는 문장이 너무 많다는 점이었습니다. 그래서 검색 방식 비교와 별개로, 질문을 분류하고 걸러 내는 규칙을 다듬는 일이 계속 이어졌습니다.
규제가 강한 분야라서 개인정보 부담까지 지고 싶지 않았습니다. 구매이력 조회는 사이트에서는 본인 확인 수단이 없어 기능에서 뺐고, 카카오톡은 런칭 전이라 계산 부분만 만들었습니다. 개인정보 위반으로 처벌받는 사례가 많아서, 외부 AI에는 의도분류만 보내고 보내기 전에 전화번호, 이메일, 카드번호를 가립니다. 사이트에서는 이름과 연락처를 요구하지 않고 입력한 문장도 저장하지 않습니다. 이름은 아직 가리지 못해서, 처리 방식을 정해야 하는 항목으로 남아 있습니다.