대치동 입시 정보를 데이터로 풀어 쓰는 교육 블로그

대치동 학군 입시 정보에 관심 있는 학부모와 학생입니다(PRD). 홈 문구는 '데이터로 분석하는 입시 정보 가이드'입니다.
국어, 수학, 영어, 과학, 이슈 다섯 카테고리로 나눴습니다. 공개 글은 116개입니다(이슈 67, 국어 19, 수학 13, 영어 11, 과학 6).
강사와 학원의 실명을 노출하지 않고, 검증되지 않은 통계와 순위를 만들어 쓰지 않습니다(PRD 절대 제약).
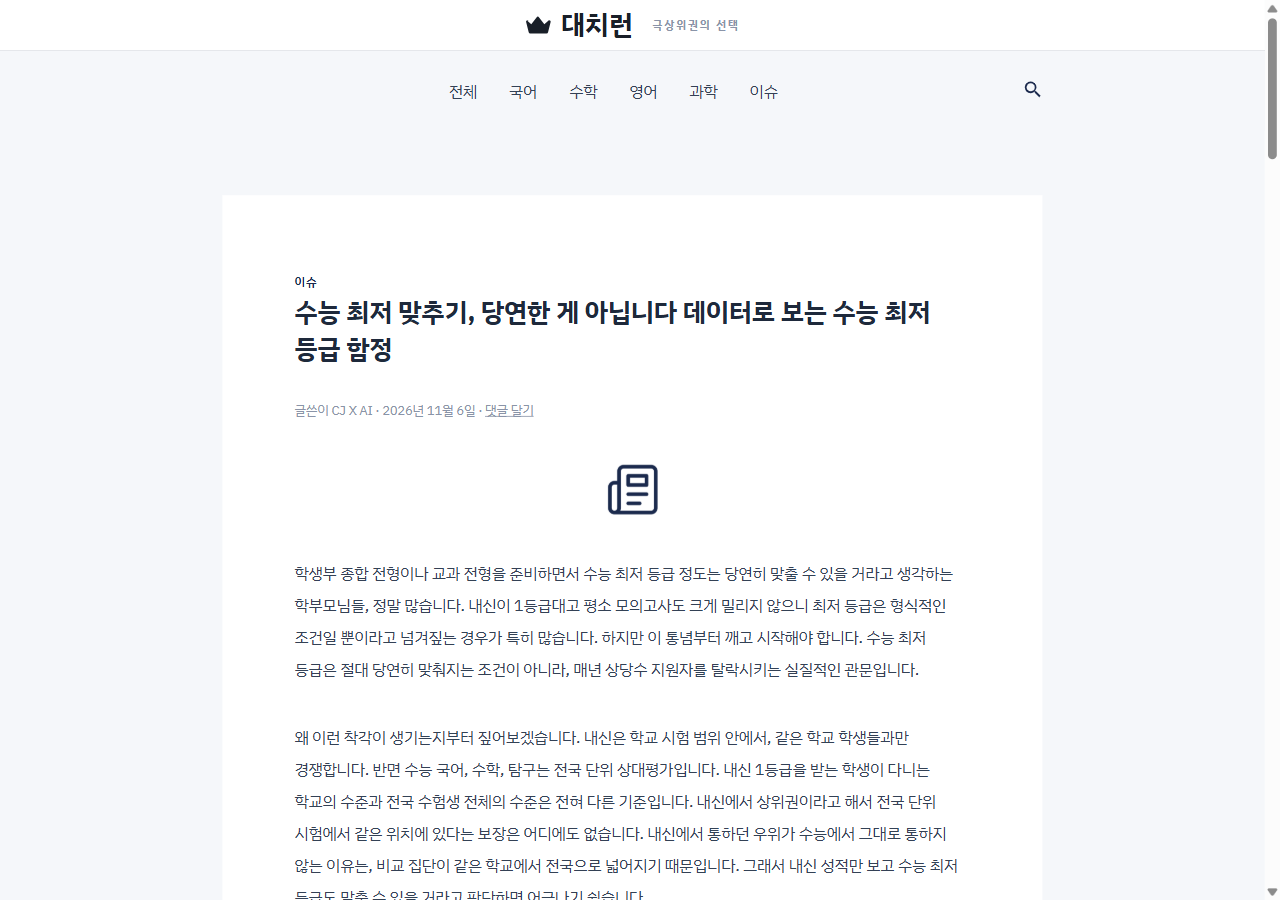
워드프레스 블로그 2개(대치런, 비타에비뉴)를 n8n 자동발행, 게시 전 사람 검수, 이슈 기록으로 운영하고 있습니다. 자동으로 만든 초안의 틀린 수치와 효능 오인 표현을 어떻게 다루었는지가 이 프로젝트의 중심입니다.
두 블로그는 n8n이 매일 초안을 만들지만, 자동 초안에는 근거 없는 수치와 틀린 서술이 섞였습니다. 1년 전 통계를 최근 통계처럼 쓰거나, 두 과목의 등급 비율이 2~4배 차이 난다고 썼는데 실제 공식 자료는 거의 같았던 사례가 있었습니다. 건강기능식품 블로그는 질병 예방·치료로 오인될 표현을 쓰면 건강기능식품법·의료광고법 문제가 될 수 있습니다. 두 사이트 모두 구글 애드센스에서 '가치가 별로 없는 콘텐츠'로 반려되어, 글 수를 늘리는 일보다 글의 품질과 측정이 과제가 되었습니다. 그래서 초안 생성은 자동으로 두고, 게시 전 검수와 기록은 사람이 맡는 구조로 정리했습니다.
2026-08-30 네이버 크로스포스팅 자동화를 시험하다가 '임시저장까지만' 한다는 안전장치가 지켜지지 않고 실제로 발행되었고, 같은 내용의 글이 라이브에 두 개 생겼습니다. 새 글이 없다는 조건에서 대체 자료를 임의로 쓰고, 결과를 확인하지 않은 채 성공으로 보고한 것도 문제였습니다. 이 사고를 이슈(#12)로 남기고 프로젝트 규칙 최상위에 '신속성보다 정확성, 조건이 안 맞으면 멈추고 묻는다'를 적었습니다. 10월 11일에도 네이버 전용 주제를 지시 없이 워드프레스에 게시했다가 약 1분 만에 초안으로 되돌린 일(#67)이 있어, 게시 대상 사이트가 불분명하면 먼저 묻는 규칙을 더했습니다.
두 사이트가 같은 사유('가치가 별로 없는 콘텐츠')로 반려되었습니다. 지목된 원인 4가지 중 실제로 조치한 것은 획일적인 글 틀 하나뿐이었고, ads.txt는 확인 결과 문제가 아니었습니다. Search Console API를 연동해 보니 비타에비뉴는 77개 글 중 43개(56%)가 28일간 검색에 한 번도 안 떴고 대치런은 49개 중 10개(20%)였습니다. 색인 차단 요인은 모두 정상이어서 콘텐츠 문제로 좁혔고, 대책을 우선순위로 정리했습니다. 또 대치런의 '개별 글 색인 0건'이라는 첫 결론이 조회 오류였음을 확인해 이슈(#41)에서 정정했습니다. 10월 8일 기준 두 사이트 모두 승인을 받지 못했습니다.
2026-10-04 자동 초안에서 틀린 수치 두 건을 발견했습니다. 1년 전 통계를 최근 통계로 쓴 글, 통합사회·통합과학 2등급 비율이 2~4배 차이 난다고 쓴 글(공식 자료는 둘 다 11~14%로 거의 같음)입니다. n8n 안에 AI 팩트체크 단계를 넣어 보았지만 프롬프트 문법 오류, 2분 초과 시간 초과, 응답 길이 한도 잘림이 이어졌습니다. 검증 단계가 초안 생성 앞에 있어서 검증이 실패하면 글이 만들어지지도 않았습니다. 세 번 실패한 뒤 전부 되돌리고, 초안이 생기면 Claude Code로 원문을 대조해 고친 뒤 게시하는 방식으로 정했습니다.
건강기능식품 글 전체를 한 번 점검하기 위해 규칙을 먼저 만들었습니다. 질병 예방·치료 효능 오인, 의약품 오인, 식약처 인정 문구와 다른 표현, 출처 없는 수치, 따라 하면 위험한 조언을 등급(A 수정 필요, B 확인 필요, C 참고)으로 나눴고, 어휘와 일반 상식은 지적하지 않는다고 적었습니다. 139건 결과는 A 3건, B 20건이었고 위험 조언은 없었습니다. 임시저장으로 돌리고 문구를 고친 글이 5건 있었습니다. 이 검수는 규칙에 걸리는 문장을 자동으로 뽑은 뒤 문맥을 읽은 것이며 글 전체를 처음부터 읽은 것은 아니라는 한계와, 법적 판단이 아니라는 점을 문서에 밝혔습니다.